Fit înainte de management.
TeamCreator există pentru momentul care precede managementul unei echipe: alegerea unei configurații de lucru care poate fi explicată, verificată și corectată înainte ca proiectul să devină doar o succesiune de blocaje.
POZIȚIEAcest text este o bază de cercetare și o propunere de program doctoral. Nu este o demonstrație de performanță predictivă și nu oferă un scor permanent pentru oameni.
Problema nu este lipsa unui dashboard. Este lipsa unei definiții bune a fit-ului.
Majoritatea sistemelor organizaționale pornesc cu echipa deja formată. Ele ajută la planificare, taskuri, feedback, obiective și raportare. TeamCreator începe mai devreme: atunci când un proiect este încă o ipoteză, iar întrebarea este dacă o anumită combinație de competențe, capacitate, moduri de lucru și interfețe poate susține acel proiect.
Mai întâi demonstrăm că scenariul este fezabil. Apoi arătăm compromisurile și dovezile. Abia după aceea discutăm despre automatizare sau modele mai complexe.
Fiecare afirmație trebuie să aibă o definiție operațională, o fereastră de timp, un baseline, o limită de utilizare și un mod de a fi infirmată.
Fit до управления.
TeamCreator существует для момента до управления командой: выбора рабочей конфигурации, которую можно объяснить, проверить и исправить до того, как проект превратится в последовательность блокировок.
ПОЗИЦИЯЭтот текст является исследовательской базой и предложением докторской программы. Это не демонстрация predictive performance и не постоянный score для людей.
Проблема не в отсутствии dashboard. Проблема в отсутствии хорошего определения fit.
Большинство организационных систем начинают с уже сформированной командой. Они помогают с планированием, task, feedback, objectives и reporting. TeamCreator начинает раньше: когда проект еще является гипотезой и нужно понять, способна ли определенная комбинация компетенций, capacity, рабочих способов и интерфейсов поддержать этот проект.
Сначала проверяем, что сценарий выполним. Затем показываем компромиссы и evidence. Только после этого обсуждаем автоматизацию или более сложные модели.
Каждое утверждение должно иметь operational definition, временное окно, baseline, ограничение использования и способ быть опровергнутым.
O problemă de decizie, nu o poveste despre oameni.
Ideea TeamCreator pornește dintr-o observație simplă, dar incomodă. Unele eșecuri de echipă sunt tratate ca probleme de management după ce configurația inițială a făcut deja proiectul fragil. Se încearcă apoi mai multă comunicare, mai multe ședințe și mai multe instrumente de urmărire. Uneori acestea ajută. Dar ele nu pot repara o interfață critică fără owner, o dependență fără capacitate sau un brief care cere simultan disponibilitate, expertiză și coordonare într-un interval imposibil.
De aici rezultă motivul de a exista: înainte de management există o problemă de formare. Formarea unei echipe nu este un clasament universal al persoanelor. Este o decizie condiționată de un proiect, de un context, de o fereastră temporală și de dovezile disponibile în acel moment.
Fit-ul este compatibilitatea condiționată dintre structura cerută de o sarcină și configurația unei echipe, observată într-un context și într-un interval de timp declarat. Nu înseamnă asemănare, „cultură” măsurată implicit sau o esență personală.
Ce se schimbă când punem fit-ul înaintea managementului
„Cine este cel mai bun?”
Întrebarea produce presiune pentru un scor global și ascunde faptul că valoarea depinde de task, rol, timp și interdependențe.
„Ce scenarii sunt fezabile?”
Comparam configurații explicabile, arătăm lipsurile de dovezi și păstrăm proprietarul deciziei în buclă.
Acesta este și motivul pentru care TeamCreator nu trebuie să fie prezentat ca un sistem care „cunoaște oamenii”. Un produs de acest tip ar fi tentat să transforme urmele de lucru în judecăți despre caracter. Programul nostru face invers: limitează obiectul, păstrează proveniența, arată necunoscutul și cere o observație viitoare înainte de a transforma o ipoteză într-o concluzie.
Formalizăm o fereastră de lucru.
Unitatea de analiză trebuie să fie suficient de precisă pentru modelare și suficient de apropiată de realitatea organizațională pentru a putea fi observată. Propunem perechea proiect-echipă, indexată în timp. O persoană poate apărea în mai multe ferestre și nu primește astfel un verdict stabil.
T = configurația candidată de echipă
ct = contextul la momentul t: capacitate, dependențe, fază, fusuri, instrumente
Et = dovezile disponibile la t, cu sursă și nivel de completitudine
dt = decizia proprietarului: selectează, modifică, cere date sau se abține
yt+Δ = rezultat definit pentru orizontul Δ
F(b,ct) = { T : gj(T,b,ct) ≤ 0 pentru toate constrângerile hard }
T* ∈ F, dacă o funcție de utilitate explicabilă poate compara scenariile fără a ascunde incertitudinea.
Funcția de utilitate nu este adevărul despre oameni. Este o convenție de decizie care trebuie să fie vizibilă: acoperire de roluri, capacitate, risc de handoff, redundanță, cost de coordonare, continuitate sau alte criterii aprobate pentru acel proiect. Când criteriile intră în conflict, produsul trebuie să arate frontiera compromisurilor, nu să inventeze o singură valoare neutră.
Dacă lipsesc o constrângere critică, o dovadă relevantă sau un context comparabil, sistemul nu trebuie să rankeze cu mai multă precizie. Poate returna „nu știm încă”, poate cere o verificare sau poate produce doar scenarii cu limite clare.
Un claim mai mic decât dovezile lui.
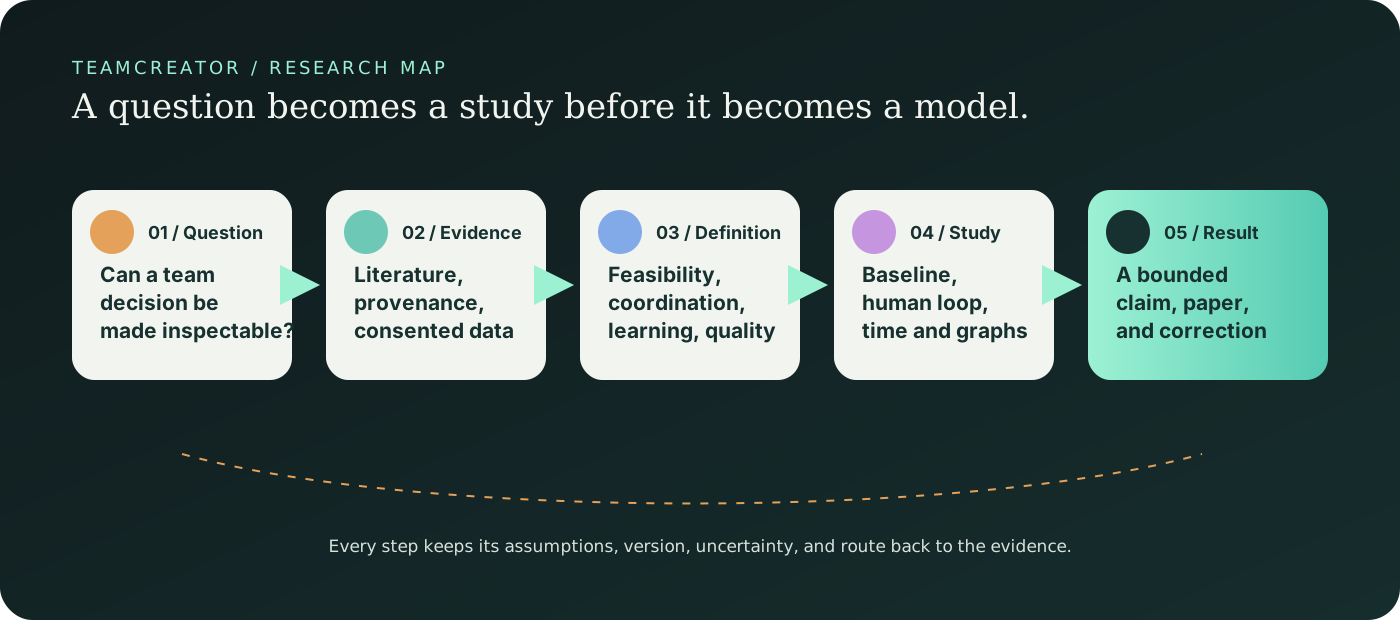
Metoda începe înainte de antrenarea unui model. Mai întâi stabilim ce este observabil, cine poate furniza observația, ce se întâmplă când datele lipsesc, ce baseline este dificil de depășit și ce rezultat poate fi măsurat fără a confunda recomandarea cu cauza rezultatului.
Scriem constructul în termeni de variabile, unitate de analiză și orizont.
Înghețăm datele, sursa și versiunea regulilor înainte de comparație.
Legăm decizia de outcome, corecție, incertitudine și următoarea ipoteză.
Ce înseamnă „științific” în produs
Un construct are un protocol
„Readiness” trebuie desfăcut în owneri, interfețe, dependențe, blocaje și alte semnale colectabile. O etichetă care nu poate fi colectată consecvent nu este o țintă curată.
Orice predicție are un Δ
Definim următorul sprint, faza următoare sau primele 30 de zile. Fără orizont, „succesul echipei” nu este un label utilizabil.
Snapshot-ul se poate relua
Aceleași date, aceleași reguli și aceeași versiune trebuie să producă aceeași explicație, cu excepția unei schimbări documentate.
Override-ul are un motiv
Corecția umană poate indica preferință, informație lipsă sau nepotrivire de workflow. Nu o tratăm automat drept adevăr, ci o urmărim până la outcome.
Întrebările de cercetare
Fezabilitate
Pot cerințele structurate și capacitatea să identifice mai devreme scenarii fragile decât un checklist de competențe?
Coordonare
Aduc interfețele observabile de lucru informație peste acoperirea de competențe, mai ales când sarcinile sunt interdependente?
Adaptare temporală
Se schimbă procesele unei echipe între episoadele proiectului și putem măsura schimbarea fără etichete permanente pentru membri?
Decizie
Comparația de scenarii legate de dovezi îmbunătățește decizia proprietarului, nu doar impresia de inteligență a interfeței?
Generalizare
Unde scade calibrarea, cine suportă costul datelor lipsă și când este mai bună abținerea decât o recomandare?
Corpul OpenAlex conține 1.000 de înregistrări selectate din 24 de familii de interogări, toate cu abstract furnizat de provider. Există o coadă de 120 de înregistrări pentru adjudecare umană. Este un strat de descoperire și sinteză, nu o revizuire sistematică PRISMA și nu dovedește transferul direct la TeamCreator.
Team science, tradusă prudent în mecanisme.
Literatura nu ne dă o formulă pentru echipa corectă. Ne oferă constructe, niveluri de analiză și limite. Traducerea responsabilă este mai modestă și mai utilă decât mitologia personalității.
Aceste teorii nu justifică să citim caracterul dintr-un mesaj, să deducem siguranța psihologică dintr-un timp de răspuns sau să folosim un embedding de personalitate în locul contextului. Pentru fiecare feature avem nevoie de definiție, sursă, agregare, fereastră de timp, missingness, permisiune de utilizare și relație declarată cu o decizie.
Un semnal care poate fi acceptabil la nivel de echipă, într-un interval și cu consimțământ, poate fi inacceptabil ca scor individual. Această diferență nu este o notă etică adăugată la final; ea schimbă matematica, schema de date și designul interfeței.
H1-H14 trebuie să poată fi infirmate.
Ipotezele sunt centrul de greutate al programului. Ele nu sunt promisiuni de marketing. Fiecare are o comparație, o măsură și o condiție de eșec. Primele studii trebuie să demonstreze că stratul de măsurare și baseline-ul sunt funcționale înainte de a folosi modele cu capacitate mai mare.
Constrângerile hard cresc fezabilitatea.
Scenariile care respectă explicit disponibilitatea, rolul, bugetul și dependențele ar trebui să aibă mai puține încălcări decât matching-ul bazat doar pe skill.
Dovezile cu proveniență reduc corecțiile evitabile.
Linkul la sursă și data observației ar trebui să ajute proprietarul să corecteze mai rapid o recomandare nepotrivită.
Fezabilitatea precede utilitatea.
Un scenariu imposibil, chiar dacă are acoperire mare pe hârtie, nu trebuie să fie prezentat ca opțiune principală.
Riscul de interfață contează peste numărul de skill-uri.
În sarcini cu dependențe, handoff-urile fără owner și redundanța zero pot explica fragilitatea mai bine decât suma competențelor.
Discoverability este o proprietate de coordonare.
Când expertiza relevantă poate fi găsită și verificată, costul de coordonare poate scădea, fără să fie nevoie de o judecată despre personalitate.
Procesele se schimbă pe faze.
O configurație potrivită la inițiere poate avea alt profil de risc în execuție sau la integrare.
Semnalele agregate sunt mai sigure decât scorurile individuale.
Indicatorii de proces la nivel de echipă pot fi utilizați pentru învățare fără a transforma o persoană într-o țintă de supraveghere.
Scenariile sunt mai potrivite decât clasamentul.
Prezentarea a două sau trei configurații cu compromisuri poate susține o decizie mai bună decât o listă ordonată de oameni.
Explicația trebuie să fie locală.
O explicație legată de brief, criteriu și sursă este mai verificabilă decât o explicație globală a modelului.
Încrederea calibrată depășește încrederea mare.
O estimare care arată când nu știe este mai utilă decât o predicție precisă doar în aparență.
Holdout-ul pe proiect este obligatoriu.
Un model care revede aceeași organizație poate memora tool-uri, roluri sau convenții și poate părea generalizabil fără să fie.
Costul de colectare face parte din performanță.
Un câștig predictiv mic nu justifică o sarcină de date intruzivă sau greu de susținut.
Corecția este semnal de cercetare, nu ground truth.
Editările umane pot indica preferință, context omis sau eroare de date. Ele au nevoie de motiv și follow-up.
Abținerea sigură îmbunătățește decizia.
Când inputurile sunt critice și lipsesc sau observația este out of distribution, recomandarea de a colecta dovezi poate bate ghicitul încrezător.
Complexitatea se câștigă prin dovezi.
Modelul candidat nu este un trofeu tehnic. Într-un domeniu cu date puține, clustered și influențate de modul în care se lucrează, prima responsabilitate este să construim un baseline care poate fi inspectat și bătut doar prin utilitate incrementală.
Constrângeri hard, componente de scor transparente, surse, missingness și abținere.
Regresie regularizată, efecte mixte, modele de count sau survival, calibrare și clustering temporal.
Ferestre, handoff graph, centralitate de dependență, secvențe, drift și ablation.
Gradient boosting, link prediction, graph embeddings și GNN ca modele candidate, nu ca verdict final.
Numai când estimandul, unitatea de assignment, orizontul, contaminarea și outcome-ul lipsă sunt declarate.
Unde intră literatura tehnică recentă
GCN combinat cu MILP
Un anchor recent explorează combinarea reprezentării grafice cu mixed-integer programming pentru formarea echipelor. Pentru TeamCreator, ideea este relevantă ca arhitectură hibridă: modelul propune, solverul respectă constrângerile, iar interfața arată compromisul. Nu este dovadă de transfer.
Citește studiul de formare a echipelorDeep reinforcement learning
Lucrările recente despre team formation tratează selecția ca problemă secvențială. Ipoteza este interesantă doar după ce recompensa, costul de explorare și efectul asupra oamenilor sunt clarificate.
Vezi anchor-ul DRLTemporal graph learning
Grafurile dinamice pot reprezenta interacțiuni sau dependențe care se schimbă. Ele cresc riscul de leakage și memorare a organizației, deci cer split-uri în timp și holdout pe proiect.
Vezi anchor-ul temporal GNNConformalizare și abstention
Conformal prediction și selective classification oferă o direcție pentru intervale sau refuzuri condiționate de risc. În această problemă, a spune „nu compar încă” este un output tehnic, nu un defect de UX.
Vezi conformalized abstentionUn sistem de acest tip trebuie să aibă două bucle distincte. Bucla hard verifică fezabilitatea. Bucla probabilistică estimează doar ceea ce poate susține și trebuie să se poată abține. Un LLM poate ajuta la extragerea și explicarea unui brief, dar nu trebuie să inventeze dovezi și nu înlocuiește solverul, split-ul sau aprobarea umană.
Datele sunt parte din teorie.
Nu există model serios fără un contract de date. Fiecare rând trebuie să spună ce reprezintă, când a fost observat, de unde vine, cu ce scop poate fi folosit și ce nu poate susține. Lipsa datelor trebuie să fie o stare explicită, nu zero mascat.
Schema minimă pentru un rând de observație
entity_level ∈ {project, team, role_interface, person_with_consent}
variable · value · unit · missing_reason · provenance_url_or_ref
consent_scope · retention_policy · feature_version · label_status
outcome_horizon · outcome_definition · evaluator · correction_reason
Un dataset public este scaffolding pentru metode, nu dovadă că TeamCreator funcționează. Datele interne pot fi mai apropiate de problemă, dar sunt și mai vulnerabile la leakage, selecție, efecte de manager și presiune asupra participanților. De aceea, pilotul trebuie să fie consimțit, minim, agregat unde se poate și documentat înainte de colectare.
Nu inferăm trăsături sensibile, sănătate, loialitate, intenție, „culture fit”, risc individual sau valoare profesională stabilă. Nu folosim recomandarea pentru angajare, concediere, promovare, disciplină sau supraveghere a performanței.
Programul are șapte trepte, nu un demo magic.
Secvența este intenționat conservatoare. Fiecare studiu trebuie să producă un artefact care îl face pe următorul posibil sau îl oprește.
Definim fit-ul
Interviuri, task analysis și mapping între brief, rol, interfață și outcome. Livrabil: dicționar de variabile și registru de claims.
Baseline fără ML
Scenarii deterministe pe briefuri retrospective. Livrabil: replay reproductibil, rate de încălcare și review uman.
Experiment cu proprietari
Comparăm checklist, baseline și scenarii explicabile. Outcome: decizie fezabilă, timp, corecții, înțelegere și trust calibrat.
Observație longitudinală
Urmărim aceleași proiecte pe faze. Testăm drift, schimbarea interfețelor și efectul lipsei de date.
Dependențe și handoff
Construim grafuri de roluri și taskuri, apoi testăm dacă semnalele de interfață adaugă informație peste coverage.
Fairness și abținere
Audităm missingness, burden, opportunity, calibrare și selecție. Testăm când sistemul trebuie să ceară dovezi în loc să rankeze.
Pilot controlat
Numai după preregistrare, instrumentare și criterii de oprire. Măsurăm outcome-uri, nu doar satisfacție de interfață.
Nu vom declara efect cauzal doar pentru că un owner a acceptat un scenariu. Acceptarea poate schimba comportamentul, iar observația nu este randomizată. Dacă un studiu vrea să estimeze efectul unui workflow, va avea nevoie de un design de intervenție, unitate de assignment, estimand, orizont și strategie pentru contaminare și missing outcomes.
Măsurăm decizia, nu doar modelul.
Accuracy poate fi o măsură secundară sau chiar nepotrivită. Un sistem poate fi exact pe un label slab, poate încălca o constrângere critică sau poate convinge un om să urmeze o recomandare greșită. Evaluarea trebuie să combine performanța tehnică, utilitatea deciziei și siguranța de utilizare.
Constraint violation
Câte scenarii încalcă o condiție hard? Câte gaps rămân fără owner sau backup?
Calibration și selective risk
Cât de corectă este încrederea și cât risc rămâne când sistemul decide să vorbească?
Correction quality
Poate proprietarul găsi eroarea, modifica scenariul și explica de ce?
Decision time
Scade timpul până la o configurație fezabilă fără a crește corecțiile ulterioare?
Appropriate reliance
Urmează oamenii sistemul când este bun și îl contestă când ar trebui?
Opportunity și burden
Cine primește opțiuni, cine este exclus de date lipsă și cine suportă costul evidenței?
Split-uri care nu negociază cu leakage-ul
Validarea trebuie să includă split temporal, holdout pe proiect, holdout pe organizație când este posibil și ablation pentru fiecare familie de feature-uri. Dacă membrii, managerii sau tool-urile apar în train și test printr-un proxy, performanța poate fi doar recunoașterea contextului. Toate rezultatele trebuie raportate cu intervale, număr de unități, missingness, criterii de excludere și eșecuri.
Nu vom calcula o metrică de grup doar pentru a arăta bine într-un tabel. Mai întâi stabilim decizia evaluată, populația, grupurile legitime și costul erorii. Nu deducem atribute protejate din text sau comportament. Dacă nu putem face auditul fără a crea o nouă intruziune, documentăm limita și reducem scopul.
Regula de utilizare
TeamCreator poate sprijini o discuție de formare și poate afișa scenarii. Nu poate lua singur o decizie de personal și nu trebuie folosit pentru angajare, concediere, promovare, disciplină sau scoring individual. „Unknown” descrie starea dovezii, nu persoana.
Istoria se notează cu granițe.
Am verificat separat traseele publice asociate cu Lucian Adrian Gavril, Cristian Ziliberberg, Vadim Iatchevici și Florin Călin Păun, precum și firul Xvaluator. Această secțiune nu transformă o asociere într-o biografie și nu pretinde că o lucrare a acestor persoane validează TeamCreator. Scopul este să păstrăm o genealogie verificabilă a ideilor, a proiectelor și a necunoscutelor.
Aalborg University, PhD projects
Anchor pentru firul public atribuit lui Cristian Ziliberberg.
UTM Journal of Economic Science
Anchor pentru firul public atribuit lui Vadim Iatchevici.
CV public Florin Călin Păun
Context de cercetare și inovare, păstrat separat de afirmațiile despre TeamCreator.
Xvaluator și calificarea datelor
Fir metodologic relevant pentru calitatea informației, fără a fi confundat cu un rezultat al nostru.
Registrul complet de status și taskurile deschise rămân în dosarul de cercetare al proiectului și în fișierele sursă cu provenance separat pentru provenit, inferat și necunoscut. Un repository public viitor va avea nevoie de o verificare de publicare distinctă.
Cum o spunem fără jargon de produs.
Pentru un grup informal, mesajul trebuie să pornească din problemă și să ajungă la întrebare. Nu spunem că am construit un detector de oameni buni. Spunem că încercăm să facem vizibilă o decizie care este adesea luată cu date fragmentare și corectată prea târziu.
TeamCreator pornește de la ideea că formarea unei echipe este o problemă de fit înainte de a fi o problemă de management. Nu vrem un scor universal pentru oameni. Vrem să luăm un brief real, să verificăm ce configurații sunt fezabile, să arătăm ce dovezi susțin fiecare scenariu și să spunem când nu știm suficient ca să recomandăm. Partea de cercetare este să vedem dacă această disciplină îmbunătățește decizia și dacă poate fi făcută fără supraveghere individuală.
În multe organizații, oamenii încearcă să repare prin management o echipă care a fost formată fără să fie analizate interfețele dintre roluri, capacitatea, dependențele și timpul disponibil. TeamCreator este un program de cercetare pentru momentul anterior. Tratăm proiectul ca pe un brief, echipa ca pe o configurație și contextul ca pe o fereastră de timp. Începem cu reguli deterministe și scenarii explicabile. Apoi testăm, în ordine, dacă dovezile de proces, rețelele temporale, modelele probabilistice și abținerea aduc utilitate reală peste baseline. Nu spunem că putem prezice succesul unei echipe. Spunem că putem construi condițiile pentru ca această afirmație să fie testată sau respinsă. În paralel, cercetăm o limită importantă: cum poți ajuta la formarea unei echipe fără să transformi comportamentul oamenilor într-un scor de angajabilitate sau de valoare personală.
Ce informație ar trebui să fie vizibilă înainte de formarea unei echipe și ce informație nu ar trebui niciodată dedusă despre o persoană?
De aici începe literatura.
Pagina publică este o narațiune. Registrul tehnic păstrează rezumate, linkuri, ipoteze, contractul de date, versiuni și statusul de verificare. Sursele de mai jos sunt puncte de pornire pentru un articol și nu sunt prezentate ca dovadă că toate rezultatele se transferă direct în produs.
- [S1] Kozlowski și Ilgen, Enhancing the effectiveness of work groups and teams. doi.org/10.1111/j.1529-1006.2006.00030.x
- [S2] Ilgen, Hollenbeck, Johnson și Jundt, Teams in organizations: From input-process-output models to IMOI models. author PDF
- [S3] Edmondson, Psychological safety and learning behavior in work teams. doi.org/10.2307/2666999
- [S4] Lewis, Mapping the mind: A cognitive perspective on transactive memory. doi.org/10.1037/0022-3514.83.6.1271
- [S5] Marks, Mathieu și Zaccaro, A temporally based framework and taxonomy of team processes. doi.org/10.1177/104649640003100105
- [S6] Tayebati și colaboratorii, Conformalized abstention. PMLR
- [S7] OpenAlex corpus TeamCreator: 1.000 de înregistrări, 24 de familii de interogări, coadă de 120 pentru adjudecare umană. corpusul de cercetare
- [S8] Documentele sursă ale proiectului: prospectusul complet, lineage register, hypothesis register, data and model contract și vizualizările standalone. detaliile sunt în repository, cu status separat pentru provenit, inferat și necunoscut
Проблема решения, а не история о людях.
TeamCreator начинается с простого, но неудобного наблюдения. Некоторые неудачи команды пытаются исправлять управлением после того, как исходная конфигурация уже сделала проект хрупким. Тогда добавляют встречи, отчеты и инструменты контроля. Иногда это помогает. Но ни один dashboard не исправит критический интерфейс без владельца, зависимость без мощности или brief, который требует недоступности, экспертизы и координации одновременно.
Отсюда причина существования продукта: до управления есть задача формирования. Формирование команды не является универсальным рейтингом людей. Это условное решение, зависящее от проекта, контекста, временного окна и доступных в этот момент доказательств.
Fit означает условную совместимость структуры задачи и конфигурации команды в объявленном контексте и временном окне. Это не сходство характеров, не скрытый culture fit и не стабильная сущность человека.
Что меняется, если поставить fit до управления
«Кто лучший?»
Такой вопрос провоцирует общий балл и скрывает зависимость ценности от задачи, роли, времени и связей между работами.
«Какие сценарии выполнимы?»
Сравниваем объяснимые конфигурации, показываем пропуски в доказательствах и сохраняем владельца решения в контуре.
Поэтому TeamCreator не должен изображать систему, которая «знает людей». Такой продукт легко превращает рабочие следы в выводы о характере. Наш подход обратный: ограничить объект, сохранить происхождение данных, показать неизвестное и потребовать будущего наблюдения прежде, чем гипотеза станет выводом.
Мы формализуем рабочее окно.
Единица анализа должна быть достаточно точной для моделирования и достаточно близкой к рабочей реальности, чтобы ее можно было наблюдать. Мы предлагаем пару проект-команда с индексом времени. Один человек может появляться в разных окнах и не получает постоянного вердикта.
T = кандидатная конфигурация команды
ct = контекст в момент t: мощность, зависимости, фаза, часовые пояса, инструменты
Et = доступные в t доказательства с источником и полнотой
dt = решение владельца: выбрать, изменить, запросить данные или воздержаться
yt+Δ = определенный результат на горизонте Δ
F(b,ct) = { T : gj(T,b,ct) ≤ 0 для всех hard-ограничений }
T* ∈ F, если объяснимая функция полезности сравнивает сценарии без скрытия неопределенности.
Функция полезности не является правдой о людях. Это видимый контракт решения: покрытие ролей, мощность, риск handoff, резерв, стоимость координации, непрерывность и другие критерии, утвержденные для конкретного проекта. Когда критерии конфликтуют, продукт должен показать компромисс, а не выдавать одну нейтральную цифру.
Если отсутствует критическое ограничение, релевантное доказательство или сопоставимый контекст, система не должна ранжировать с большей точностью. Она может вернуть «пока неизвестно», запросить проверку или показать только сценарии с ограничениями.
Каждый claim меньше своих доказательств.
Метод начинается до обучения модели. Сначала мы определяем, что наблюдаемо, кто может это предоставить, что означает пропуск, какой baseline трудно превзойти и какой результат можно измерить, не путая рекомендацию с причиной результата.
Конструкт переводится в переменные, единицу анализа и горизонт.
Данные, источник и версия правил фиксируются до сравнения.
Решение связывается с outcome, correction, неопределенностью и следующей гипотезой.
Что означает «научный» в продукте
У конструкта есть протокол
Readiness раскладывается на владельцев, интерфейсы, зависимости и блокеры. Непоследовательно собираемый label не является чистой целью.
У прогноза есть Δ
Мы задаем следующий sprint, фазу или первые 30 дней. Без горизонта успех команды не является рабочим label.
Snapshot можно повторить
Одинаковые данные, правила и версия должны выдавать одинаковое объяснение, если изменение не задокументировано.
У override есть причина
Человеческая коррекция может показывать предпочтение, пропущенный контекст или ошибку данных. Ее надо связать с будущим outcome.
Исследовательские вопросы
Выполнимость
Могут ли структурированные требования и capacity раньше выявить хрупкий сценарий, чем checklist компетенций?
Координация
Добавляют ли наблюдаемые рабочие интерфейсы информацию поверх coverage компетенций при высокой взаимозависимости?
Временная адаптация
Меняются ли процессы команды между эпизодами проекта без постоянных ярлыков для участников?
Решение
Улучшает ли сравнение сценариев, связанных с доказательствами, решение владельца, а не только впечатление от интерфейса?
Обобщение
Где ухудшается калибровка, кто несет стоимость пропусков и когда abstention лучше уверенной догадки?
OpenAlex corpus содержит 1.000 отобранных записей из 24 семейств запросов, с provider abstracts. Очередь из 120 записей требует человеческой adjudication. Это слой обнаружения и синтеза, а не PRISMA systematic review и не доказательство прямого переноса в TeamCreator.
Team science, переведенная в механизмы без лишних обещаний.
Литература не дает формулу правильной команды. Она дает конструкты, уровни анализа и ограничения. Ответственный перевод менее эффектен, зато лучше поддается проверке.
Эти теории не позволяют читать характер из сообщения, выводить psychological safety из latency или заменять контекст personality embedding. Для каждого feature нужны определение, источник, агрегация, временное окно, missingness, разрешение на использование и связь с решением.
Сигнал, допустимый на уровне команды и временного окна с согласиями, может быть недопустимым как индивидуальный score. Это меняет схему данных, модель и интерфейс, а не только ethics note.
H1-H14 должны быть опровержимыми.
Гипотезы являются центром программы. Это не обещания маркетинга. У каждой есть сравнение, метрика и условие провала.
Hard constraints повышают выполнимость.
Сценарии, учитывающие availability, role, budget и dependencies, должны нарушать меньше условий, чем matching только по skill.
Provenance снижает предотвратимые corrections.
Источник и дата наблюдения должны помогать владельцу быстрее исправить плохой сценарий.
Feasibility идет до utility.
Невыполнимый сценарий не должен показываться как лучший из-за высокого покрытия на бумаге.
Interface risk важнее суммы skills.
При зависимых задачах handoff без владельца и нулевая redundancy могут объяснить хрупкость лучше, чем число компетенций.
Discoverability является свойством координации.
Проверяемая экспертность может снижать coordination cost без суждения о личности.
Processes меняются по фазам.
Конфигурация, подходящая в начале, может иметь другой риск в execution или integration.
Агрегированные сигналы безопаснее индивидуальных scores.
Командные process signals могут использоваться для learning без превращения человека в объект наблюдения.
Сценарии лучше ranking.
Две или три конфигурации с trade-offs могут поддержать решение лучше, чем упорядоченный список людей.
Explanation должна быть локальной.
Связка brief, criterion и source проверяемее глобального объяснения модели.
Calibrated trust полезнее высокого confidence.
Оценка, показывающая границы знания, полезнее точной на вид уверенности.
Holdout по проекту обязателен.
Модель может запомнить tool, role или organizational convention и выдать ложную generalization.
Стоимость данных входит в performance.
Малый predictive gain не оправдывает intrusive или тяжелую задачу сбора данных.
Correction является research signal, не ground truth.
Human edits могут показывать preference, пропущенный context или ошибку данных и требуют причины.
Safe abstention улучшает решение.
При критических пропусках или out-of-distribution запрос доказательств может быть лучше уверенного guess.
Сложность зарабатывается доказательствами.
Модель не является техническим трофеем. В области с небольшими, clustered и контекстно зависимыми данными первая обязанность состоит в inspectable baseline, который можно честно сравнить.
Hard constraints, прозрачные компоненты, источники, missingness и abstention.
Regularized regression, mixed effects, count или survival models, calibration и temporal clustering.
Окна, handoff graph, dependency centrality, sequence features, drift и ablation.
Gradient boosting, link prediction, embeddings и GNN как кандидаты, не как verdict.
Только при ясных estimand, assignment unit, horizon, contamination и missing outcomes.
Почему recent technical work важен
GCN вместе с MILP
Recent work связывает graph representation и mixed-integer programming для team formation. Для TeamCreator это возможная hybrid architecture: model proposes, solver respects constraints, interface shows trade-offs. Это не transfer proof.
Исследование team formationDeep reinforcement learning
Recent team formation papers трактуют selection как sequential decision. Гипотеза требует определения reward, exploration cost и влияния на людей.
DRL anchorDynamic graph learning
Dynamic graphs могут представить изменяющиеся зависимости. Они усиливают риск leakage и memorization, поэтому нужны time splits и project holdout.
Temporal GNN anchorConformalized abstention
Conformal prediction и selective classification дают направление для uncertainty sets и refusers. «Еще не сравниваем» является техническим output, а не дефектом UX.
Conformalized abstentionСистеме нужны две разные петли. Hard loop проверяет feasibility. Probabilistic loop оценивает только поддерживаемое данными и умеет abstain. LLM может помогать извлечь структуру из brief, но не должен выдумывать evidence и не заменяет solver, split или человеческое approval.
Данные являются частью теории.
Нет серьезной модели без data contract. Каждая запись должна описывать, что она означает, когда наблюдалась, откуда пришла, для какой цели может использоваться и чего не подтверждает. Пропуск должен быть отдельным состоянием, а не скрытым нулем.
Минимальная схема observation
entity_level ∈ {project, team, role_interface, person_with_consent}
variable · value · unit · missing_reason · provenance_url_or_ref
consent_scope · retention_policy · feature_version · label_status
outcome_horizon · outcome_definition · evaluator · correction_reason
Public dataset является scaffolding для методов, не доказательством TeamCreator. Internal data ближе к задаче, но уязвимее для leakage, selection, manager effects и давления на участников. Поэтому pilot должен быть consented, минимальным, агрегированным где возможно и описанным до сбора.
Мы не выводим sensitive traits, health, loyalty, intent, culture fit, individual risk или постоянную professional value. Recommendation не используется для hiring, firing, promotion, discipline или performance surveillance.
Семь ступеней, не magic demo.
Sequence консервативен намеренно. Каждый study должен создать artifact, который делает следующий study возможным или останавливает его.
Определяем fit
Interviews, task analysis и mapping brief, role, interface и outcome. Deliverable: variable dictionary и claim register.
Baseline без ML
Deterministic scenarios на retrospective briefs. Deliverable: reproducible replay, violation rate и human review.
Эксперимент с owners
Checklist, baseline и explainable scenarios сравниваются по feasible decision, time, corrections, understanding и calibrated trust.
Longitudinal observation
Одни проекты наблюдаются по фазам. Тестируются drift, смена interfaces и цена missing data.
Dependencies и handoff
Role и task graphs проверяются на incremental information поверх coverage.
Fairness и abstention
Аудитируются missingness, burden, opportunity, calibration и selection. Тестируем, когда нужны evidence, а не ranking.
Контролируемый pilot
Только после preregistration, instrumentation и stopping criteria. Измеряем outcomes, не только UX satisfaction.
Мы не заявляем causal effect только потому, что owner принял сценарий. Acceptance меняет поведение и не является random assignment. Для causal вопроса нужны intervention design, assignment unit, estimand, horizon и стратегия для contamination и missing outcomes.
Измеряем решение, не только модель.
Accuracy может быть вторичной или неуместной. Система способна быть точной на слабом label, нарушать hard constraint или убеждать человека следовать ошибке. Поэтому evaluation объединяет technical performance, decision utility и safe use.
Constraint violation
Сколько сценариев нарушает hard condition? Сколько gaps остаются без owner или backup?
Calibration и selective risk
Насколько честна confidence и сколько риска остается, когда система говорит?
Correction quality
Может ли owner найти ошибку, изменить scenario и объяснить почему?
Decision time
Снижается ли время до feasible configuration без роста последующих corrections?
Appropriate reliance
Следуют ли люди системе, когда она хороша, и оспаривают ли ее, когда должны?
Opportunity и burden
Кто получает options, кто исключается missing data и кто платит за evidence?
Split, которые не договариваются с leakage
Validation должна включать temporal split, project holdout, organization holdout когда возможно и ablation для feature families. Если members, managers или tools попадают в train и test через proxy, performance может быть просто распознаванием контекста. Отчеты должны включать intervals, unit count, missingness, exclusion criteria и failure cases.
Мы не считаем group metric только для красивой таблицы. Сначала определяем decision, population, легитимные группы и стоимость ошибки. Protected attributes не выводятся из текста или поведения. Если audit создаст новую интрузию, мы сужаем scope и фиксируем ограничение.
Правило использования
TeamCreator может поддержать formation discussion и показать scenarios. Он не принимает кадровое решение и не используется для hiring, firing, promotion, discipline или individual scoring. «Unknown» описывает состояние evidence, а не человека.
Историю нужно записывать с границами.
Мы отдельно проверили публичные следы, связанные с Lucian Adrian Gavril, Cristian Ziliberberg, Vadim Iatchevici и Florin Călin Păun, а также линию Xvaluator. Этот раздел не превращает association в biography и не утверждает, что чья-либо публикация подтверждает TeamCreator. Цель состоит в проверяемой истории идей, проектов и неизвестных.
Public CV Florin Călin Păun
Research и innovation context, отделенный от TeamCreator claims.
Полный status register и open verification tasks остаются в рабочем research dossier. Имена, источники и unresolved points должны проходить отдельную double-check перед публикацией статьи.
Как говорить без product jargon.
В неформальной группе сообщение должно идти от проблемы к вопросу. Мы не говорим, что построили detector хороших людей. Мы говорим, что пытаемся сделать видимым решение, которое часто принимается на фрагментарных данных и исправляется слишком поздно.
TeamCreator исходит из идеи, что формирование команды является проблемой fit до того, как становится проблемой управления. Мы не хотим универсальный score для людей. Мы хотим взять реальный brief, проверить выполнимые конфигурации, показать evidence для каждого scenario и вовремя сказать, когда данных недостаточно. Исследовательская часть состоит в том, чтобы проверить, улучшает ли эта дисциплина решение и можно ли сделать это без индивидуального наблюдения.
Во многих организациях управлением пытаются исправить команду, сформированную без анализа интерфейсов ролей, capacity, зависимостей и доступного времени. TeamCreator исследует момент до управления. Проект рассматривается как brief, команда как configuration, context как time window. Сначала мы строим deterministic rules и explainable scenarios. Потом последовательно проверяем, добавляют ли process evidence, temporal networks, probabilistic models и abstention полезность поверх baseline. Мы не утверждаем, что умеем предсказывать успех команды. Мы утверждаем, что можем построить условия, при которых такую гипотезу можно проверить или отвергнуть. Вторая граница не менее важна: как помогать формировать команду, не превращая рабочее поведение в score employability или personal value.
Какая информация должна быть видна до формирования команды, а какая информация никогда не должна выводиться о человеке?
Отсюда начинается литература.
Public page является narrative layer. Technical register хранит abstracts, links, hypotheses, data contract, versions и verification status. Источники ниже являются entry points для paper и не заявляются как direct transfer proof.
- [S1] Kozlowski и Ilgen, Enhancing the effectiveness of work groups and teams. doi.org/10.1111/j.1529-1006.2006.00030.x
- [S2] Ilgen, Hollenbeck, Johnson и Jundt, Teams in organizations: From input-process-output models to IMOI models. author PDF
- [S3] Edmondson, Psychological safety and learning behavior in work teams. doi.org/10.2307/2666999
- [S4] Lewis, Mapping the mind: A cognitive perspective on transactive memory. doi.org/10.1037/0022-3514.83.6.1271
- [S5] Marks, Mathieu и Zaccaro, A temporally based framework and taxonomy of team processes. doi.org/10.1177/104649640003100105
- [S6] Tayebati и collaborators, Conformalized abstention. PMLR
- [S7] TeamCreator OpenAlex corpus: 1.000 records, 24 query families, 120-record human review queue. research corpus
- [S8] Project source files: full prospectus, lineage register, hypothesis register, data and model contract, standalone visuals. provenance and claim status are kept separately